더빙 · 음성 · 음악 · 전사

내 영상을 다른 언어로.
더빙된 오디오가 약 1분 만에 돌아와요.

Dub 페이지에서 파일을 업로드하고 언어를 고르면, Omnibo가 더빙을 오디오 파일로 돌려줘요. 영상은 돌려주지 않고 입 모양도 맞추지 않아요. 2026년 11월 5일의 테스트 작업 4건에서 16~20초짜리 파일이 각각 약 1분 만에 돌아왔어요.

동틀 녘의 소금 평원Charon 낭독 · Gemini 3.8 Flash-Lite TTS

더빙, 목소리,
음악, 전사.

파일을 다른 언어로 더빙

Dub 페이지에서 업로드하고 언어를 고르세요. 돌려받는 것은 더빙된 오디오 파일이고, 영상이 아니며, 입 모양도 맞추지 않아요. Dubbing v1은(는) 600 cr / 분이고 Starter 이상이 필요해요. Dubbing v2은(는) 2,640 cr / 분이고 Pro 이상이 필요해요.

다양한 목소리의 음성

내레이션, 대화, 광고를 고르기 전에 들어 볼 수 있는 목소리로 읽어 줘요. 사용 권한이 있는 목소리를 복제하세요.

음악, 효과음, 전사

장면에 음악을 입히고, 필요한 효과음을 더하고, 녹음을 타임스탬프가 붙은 깔끔한 텍스트로 바꿔요.

채팅에서 더빙을 요청해도 이 페이지는 쓰이지 않아요. 작업 하나는 최대 10분이에요. 페이지는 Dubbing v2로 열려요. 더 낮은 요율을 원하면 Dubbing v1을(를) 고르세요.

제공업체 8곳의 오디오 모델 32개 중에서 고르세요. 모델마다 공개된 요율이 있어요.

모든 모델 보기

음성 및 오디오,
일하는 방식 그대로.

텍스트를 음성으로 바꾸고, 장면에 음악이나 효과음을 입히고, 녹음을 전사하고, 사용 권한이 있는 목소리를 복제하세요.

01 / 04

텍스트 음성 변환

내레이션, 대사, 광고를 딱 맞는 목소리로. 쓰기 전에 모든 목소리를 미리 들어 볼 수 있어요.

02 / 04

음악과 사운드

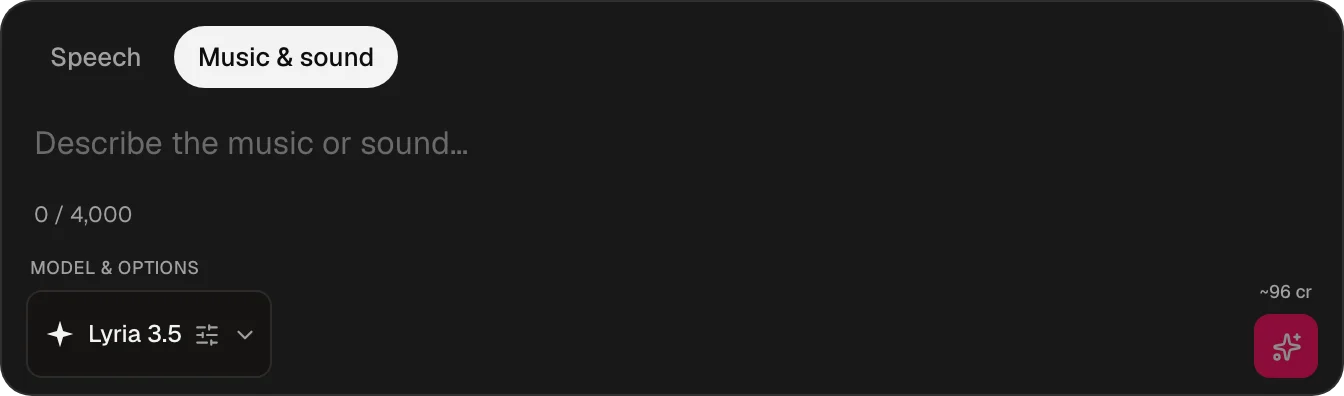
장면에 음악을 입히거나 필요한 효과음을 더하세요. 같은 컴포저에서요.

03 / 04

어떤 녹음이든 전사하세요

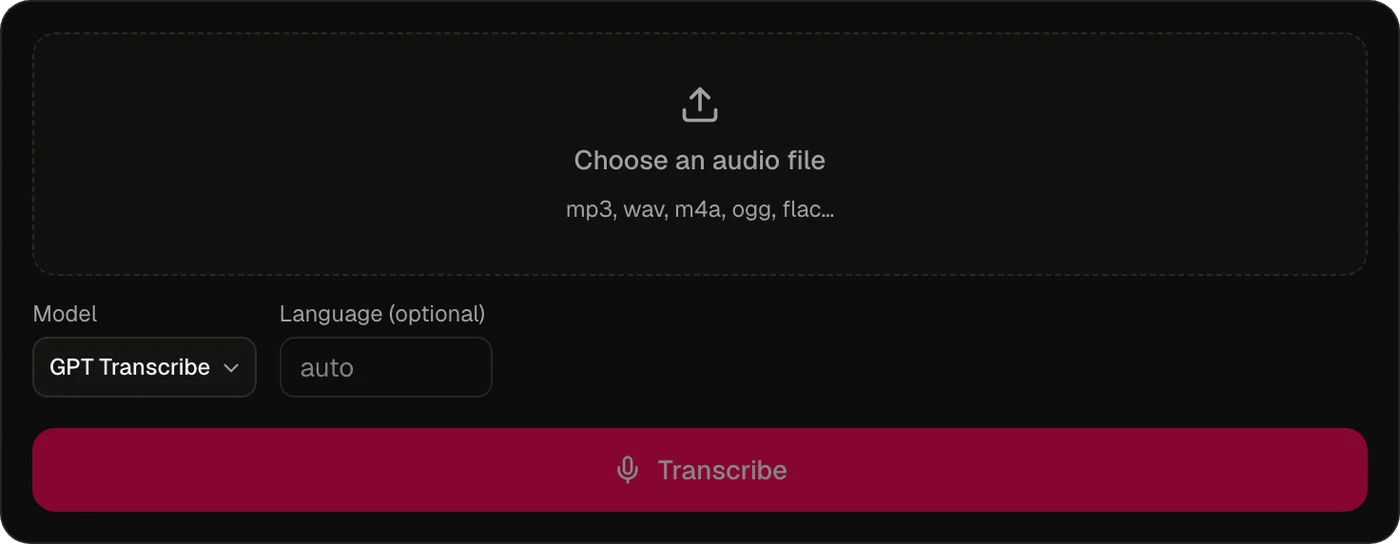
오디오 파일을 끌어다 놓고, 모델을 고르고, 원하면 언어도 고르면 깔끔한 타임스탬프 텍스트가 돌아와요.

04 / 04

음성을 복제하세요

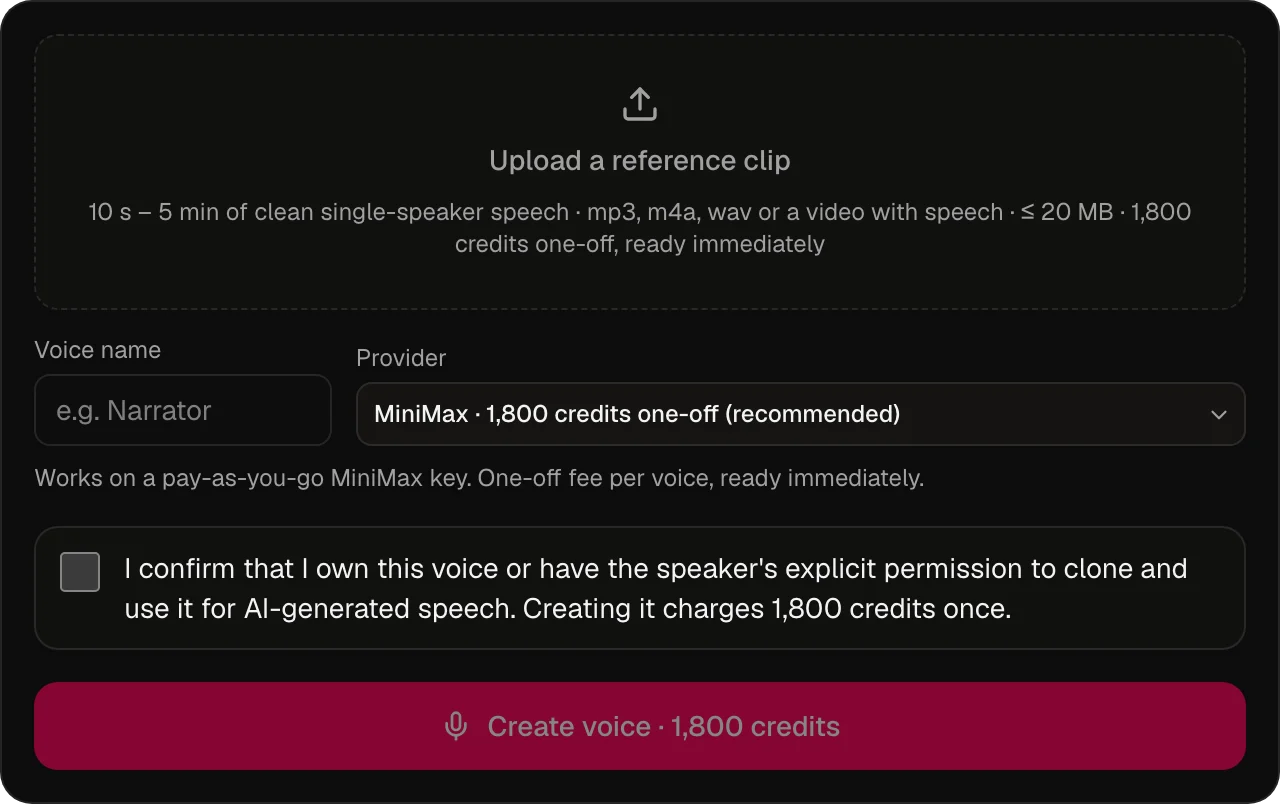
사용 권한이 있는 짧은 참고 클립을 업로드하고 목소리에 이름을 붙이면, 그때부터 그 목소리로 말할 수 있어요.
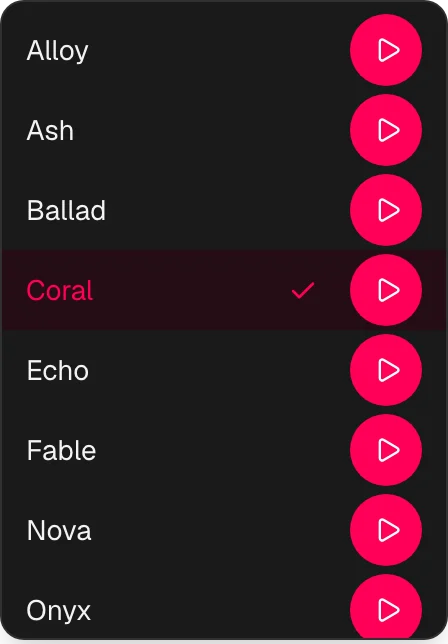
음성 목록. 각 목소리마다 미리 듣는 재생 버튼이 있음
'음악과 사운드' 모드의 Omnibo 오디오 컴포저
Omnibo 전사: 녹음 파일을 놓고 모델과 언어 선택
Omnibo 음성 복제: 참고 클립 업로드, 목소리 이름 지정, 제공업체 선택

직접
들어 보세요.

커뮤니티 피드의 실제 음성과, 읽은 모델과 목소리.

4층에 내리는 비Enceladus 낭독 · Gemini 3.8 Flash-Lite TTS
늦잠 잔 등대Leda 낭독 · Gemini 3.8 Flash-Lite TTS
10분, 갈 곳은 없다sage 낭독 · GPT-4o mini TTS
좋은 것의 무게ballad 낭독 · GPT-4o mini TTS
4번 갤러리, 9번째 정류장carina 낭독 · Grok Voice
남은 신호 하나rex 낭독 · Grok Voice

오디오 모델 32개.
모델마다 요율이 있어요.

모든 모델과 제공업체, 공개된 요율, 필요한 요금제, 출시된 날짜.

전체 모델 →
ElevenLabs오디오 모델 9개
fal.ai오디오 모델 7개
Google오디오 모델 5개
OpenAI오디오 모델 4개
ByteDance오디오 모델 2개
MiniMax오디오 모델 2개
xAI오디오 모델 2개
Kling AI오디오 모델 1개
모델제공업체요율요금제추가일
ElevenLabs Sound Effects v3ElevenLabs2.4 cr / 초Starter11월 5일 2026
Dubbing v1ElevenLabs600 cr / 분Starter11월 2일 2026
Dubbing v2ElevenLabs2,640 cr / 분Pro11월 2일 2026
MiniMax Music 3fal.ai2.4 cr / 초Pro10월 30일 2026
Stable Audio 3 Mediumfal.ai45.1 cr / 클립Pro10월 30일 2026
Stable Audio 3 Small Musicfal.ai26 cr / 클립Starter10월 30일 2026
Stable Audio 3 Small SFXfal.ai24.7 cr / 클립Starter10월 30일 2026
Gemini 3.8 Flash-Lite TTSGoogle25,800 cr / 100만 자Starter10월 10일 2026
Gemini 3.8 Flash TTSGoogle38,520 cr / 100만 자Pro10월 10일 2026
Eleven v4ElevenLabs96,000 cr / 100만 자Pro10월 6일 2026
CassetteAI Sound Effectsfal.ai12 cr / 클립Starter9월 14일 2026
Eleven Flash v2.5ElevenLabs48,000 cr / 100만 자Starter9월 14일 2026
Eleven Multilingual v2ElevenLabs96,000 cr / 100만 자Pro9월 14일 2026
Eleven Music v2.5ElevenLabs3 cr / 초Pro9월 14일 2026
Eleven v3ElevenLabs96,000 cr / 100만 자Pro9월 14일 2026
MiniMax Music 2.6fal.ai180 cr / 클립Pro9월 14일 2026
Scribe v2ElevenLabs4.4 cr / 분Starter9월 14일 2026
Stable Audio 2.5fal.ai240 cr / 클립Pro9월 14일 2026
Kling Text to AudioKling AI42 cr / 클립Starter9월 13일 2026
Lyria 3 ClipGoogle48 cr / 클립Starter9월 13일 2026
Lyria 3.5Google96 cr / 클립Pro9월 13일 2026
Seed Audio 1.0ByteDance3 cr / 초Starter9월 13일 2026
Gemini 3.5 TranscribeGoogle6 cr / 분Starter9월 8일 2026
MiniMax Speech 2.8 HDMiniMax120,000 cr / 100만 자Pro8월 30일 2026
MiniMax Speech 2.8 TurboMiniMax72,000 cr / 100만 자Pro8월 30일 2026
GPT TranscribeOpenAI5.4 cr / 분Starter8월 8일 2026
GPT-4o mini TTSOpenAI22,800 cr / 100만 자Starter7월 5일 2026
Grok TranscribexAI2 cr / 분Starter7월 5일 2026
Grok VoicexAI18,000 cr / 100만 자Starter7월 5일 2026
Seed TTS 1.0ByteDance36,000 cr / 100만 자Starter7월 5일 2026
TTS-1OpenAI18,000 cr / 100만 자Starter7월 5일 2026
TTS-1 HDOpenAI36,000 cr / 100만 자Pro7월 5일 2026

궁금한 점,
답해 드려요.

Omnibo에는 어떤 오디오 모델이 있나요?

8개 제공업체의 오디오 모델 32개: ElevenLabs, fal.ai, Google, OpenAI, ByteDance, MiniMax, xAI, Kling AI. 가장 최신 모델: ElevenLabs Sound Effects v3 (2026년 11월 5일에 추가).

오디오를 생성하면 얼마인가요?

모델마다 공개된 요율이 있어요. 위의 표에 모든 요율과 단위가 나와 있어요.

내 목소리를 복제할 수 있나요?

네. 짧은 샘플을 녹음하면 어떤 텍스트에든 내 목소리를 쓸 수 있어요.

Omnibo가 녹음을 전사할 수 있나요?

네. 어떤 녹음이든 깔끔한 타임스탬프 텍스트로 바꿔 드려요.

다음 아이디어는
여기서 시작됩니다.

무료 계정을 만드세요. 카드는 필요 없습니다. 더 필요해지면 업그레이드하세요.

무료 계정 만들기 →