吹き替え · 音声 · 音楽 · 文字起こし

あなたの動画を、別の言語で。
吹き替え音声が、約1分で戻ります。

Dubページでファイルをアップロードして言語を選ぶと、Omniboが吹き替えを音声ファイルで返します。動画は返さず、口の動きも合わせません。2026年11月5日の4件のテストジョブでは、16〜20秒のファイルがそれぞれ約1分で戻りました。

夜明けの塩原Charonによる朗読 · Gemini 3.8 Flash-Lite TTS

吹き替え、声、
音楽、文字起こし。

ファイルを別の言語に吹き替え

Dubページでアップロードして言語を選びます。戻ってくるのは吹き替え済みの音声ファイルで、動画ではなく、口の動きも合わせません。Dubbing v1は600 cr / 分で、Starter以上が必要です。Dubbing v2は2,640 cr / 分で、Pro以上が必要です。

さまざまな声で音声

ナレーション、会話、広告を、選ぶ前に試聴できる声で読み上げます。使用許可のある声をクローンできます。

音楽、効果音、文字起こし

シーンに音楽をつけ、必要な効果音を足し、録音をタイムスタンプ付きのきれいなテキストにします。

チャットで吹き替えを頼んでも、このページは使われません。ジョブは最長10分です。ページはDubbing v2で開きます。低いレートにするにはDubbing v1を選んでください。

8社のプロバイダーの32個の音声モデルから選べます。どれにも公表されたレートがあります。

すべてのモデルを見る

音声とオーディオ、
あなたの働き方に合わせて。

テキストを音声にし、シーンに音楽や効果音をつけ、録音を文字起こしし、使用許可のあるボイスをクローンできます。

01 / 04

テキスト読み上げ

ナレーション、セリフ、広告を、ぴったりの声で。使う前にすべての声をプレビューできます。

02 / 04

音楽とサウンド

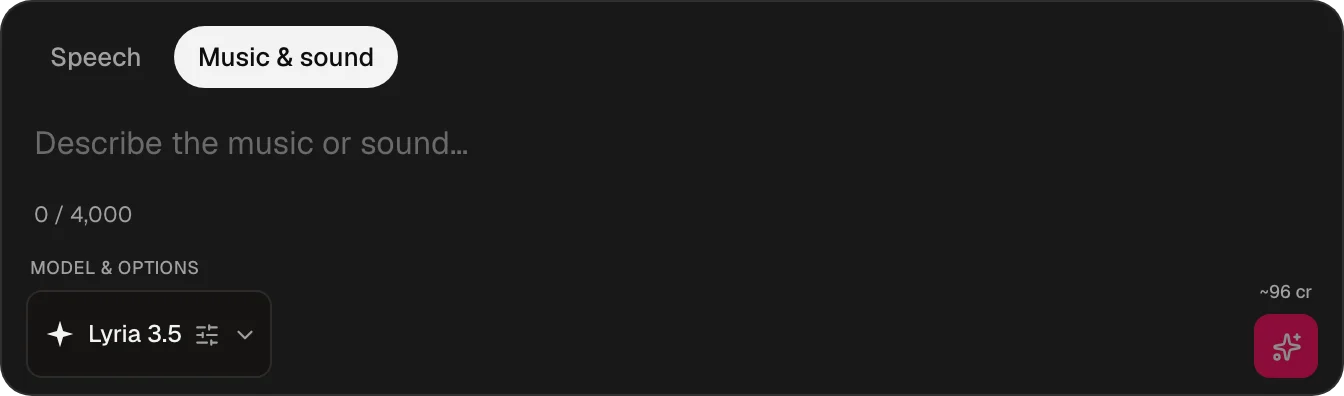
シーンに音楽をつけたり、必要な効果音を加えたり。同じコンポーザーから。

03 / 04

どんな録音も文字起こし

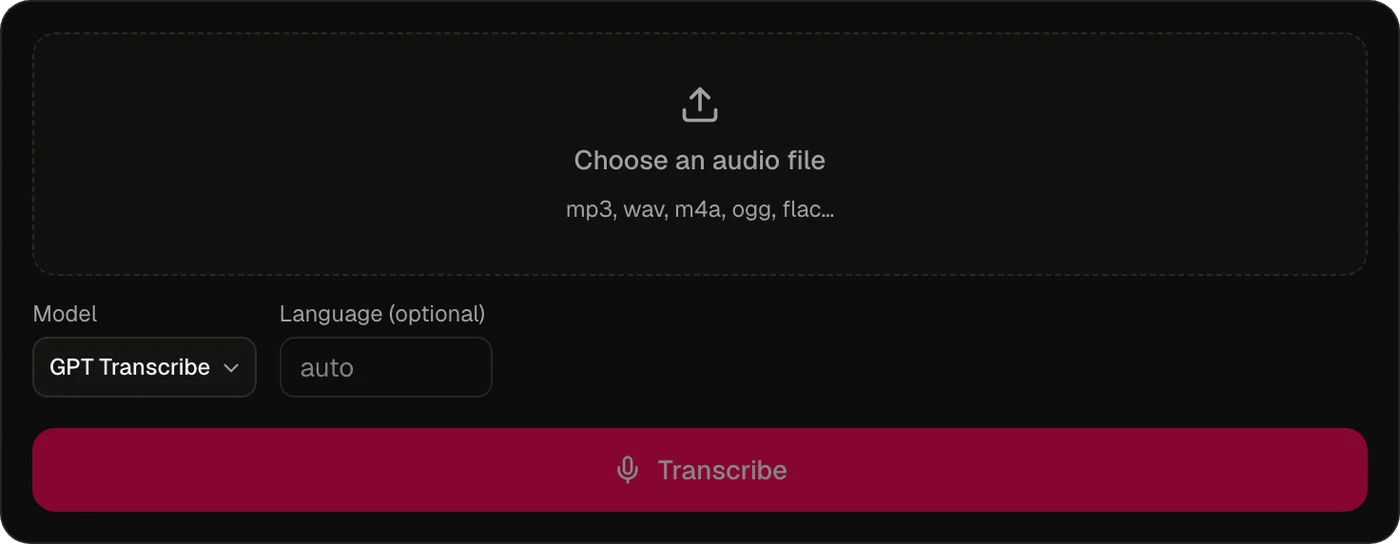
音声ファイルをドロップし、モデルを選び、必要なら言語も選ぶと、タイムスタンプ付きのきれいなテキストが返ってきます。

04 / 04

ボイスをクローン

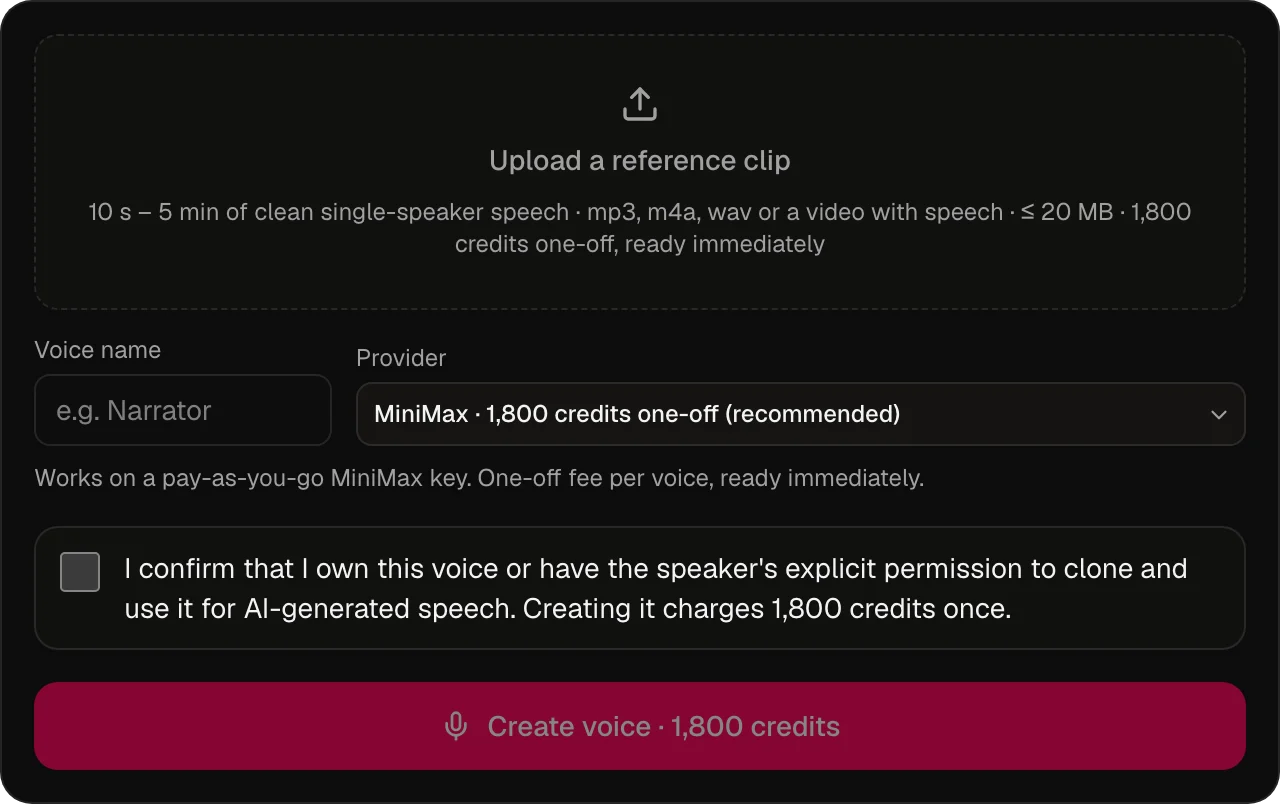
使用許可のある短い参考クリップをアップロードし、ボイスに名前をつけると、以後はその声で話せます。
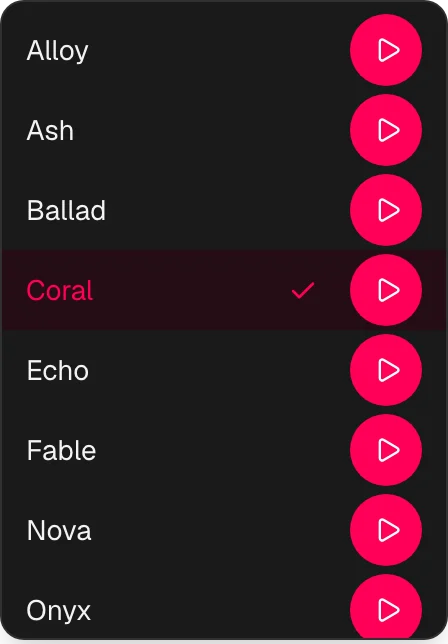
音声の一覧。各ボイスに再生ボタンがあり、プレビューできる
「音楽とサウンド」モードのOmniboオーディオコンポーザー
Omniboの文字起こし:録音をドロップして、モデルと言語を選択
Omniboのボイスクローン:参考クリップをアップロードし、ボイスに名前をつけ、プロバイダーを選択

その耳で、
確かめてください。

コミュニティフィードの実際の音声を、読み上げたモデルとボイスとともに。

4階の雨Enceladusによる朗読 · Gemini 3.8 Flash-Lite TTS
寝過ごした灯台Ledaによる朗読 · Gemini 3.8 Flash-Lite TTS
10分間、行く先なしsageによる朗読 · GPT-4o mini TTS
良いものの重みballadによる朗読 · GPT-4o mini TTS
ギャラリー4、第9停留所carinaによる朗読 · Grok Voice
残りひとつの信号rexによる朗読 · Grok Voice

オーディオモデル32個。
それぞれにレートを公表。

すべてのモデル、そのプロバイダー、公表されたレート、必要なプラン、登場した日。

すべてのモデル →
ElevenLabsオーディオモデル9個
fal.aiオーディオモデル7個
Googleオーディオモデル5個
OpenAIオーディオモデル4個
ByteDanceオーディオモデル2個
MiniMaxオーディオモデル2個
xAIオーディオモデル2個
Kling AIオーディオモデル1個
モデルプロバイダーレートプラン追加日
ElevenLabs Sound Effects v3ElevenLabs2.4 cr / 秒Starter11月5日 2026
Dubbing v1ElevenLabs600 cr / 分Starter11月2日 2026
Dubbing v2ElevenLabs2,640 cr / 分Pro11月2日 2026
MiniMax Music 3fal.ai2.4 cr / 秒Pro10月30日 2026
Stable Audio 3 Mediumfal.ai45.1 cr / クリップPro10月30日 2026
Stable Audio 3 Small Musicfal.ai26 cr / クリップStarter10月30日 2026
Stable Audio 3 Small SFXfal.ai24.7 cr / クリップStarter10月30日 2026
Gemini 3.8 Flash-Lite TTSGoogle25,800 cr / 100万文字Starter10月10日 2026
Gemini 3.8 Flash TTSGoogle38,520 cr / 100万文字Pro10月10日 2026
Eleven v4ElevenLabs96,000 cr / 100万文字Pro10月6日 2026
CassetteAI Sound Effectsfal.ai12 cr / クリップStarter9月14日 2026
Eleven Flash v2.5ElevenLabs48,000 cr / 100万文字Starter9月14日 2026
Eleven Multilingual v2ElevenLabs96,000 cr / 100万文字Pro9月14日 2026
Eleven Music v2.5ElevenLabs3 cr / 秒Pro9月14日 2026
Eleven v3ElevenLabs96,000 cr / 100万文字Pro9月14日 2026
MiniMax Music 2.6fal.ai180 cr / クリップPro9月14日 2026
Scribe v2ElevenLabs4.4 cr / 分Starter9月14日 2026
Stable Audio 2.5fal.ai240 cr / クリップPro9月14日 2026
Kling Text to AudioKling AI42 cr / クリップStarter9月13日 2026
Lyria 3 ClipGoogle48 cr / クリップStarter9月13日 2026
Lyria 3.5Google96 cr / クリップPro9月13日 2026
Seed Audio 1.0ByteDance3 cr / 秒Starter9月13日 2026
Gemini 3.5 TranscribeGoogle6 cr / 分Starter9月8日 2026
MiniMax Speech 2.8 HDMiniMax120,000 cr / 100万文字Pro8月30日 2026
MiniMax Speech 2.8 TurboMiniMax72,000 cr / 100万文字Pro8月30日 2026
GPT TranscribeOpenAI5.4 cr / 分Starter8月8日 2026
GPT-4o mini TTSOpenAI22,800 cr / 100万文字Starter7月5日 2026
Grok TranscribexAI2 cr / 分Starter7月5日 2026
Grok VoicexAI18,000 cr / 100万文字Starter7月5日 2026
Seed TTS 1.0ByteDance36,000 cr / 100万文字Starter7月5日 2026
TTS-1OpenAI18,000 cr / 100万文字Starter7月5日 2026
TTS-1 HDOpenAI36,000 cr / 100万文字Pro7月5日 2026

よくある質問に、
お答えします。

Omniboにはどんなオーディオモデルがありますか?

8社のプロバイダーによる32個のオーディオモデル:ElevenLabs, fal.ai, Google, OpenAI, ByteDance, MiniMax, xAI, Kling AI。最新のモデルはElevenLabs Sound Effects v3(2026年11月5日に追加)。

オーディオの生成にはいくらかかりますか?

各モデルには公表されたレートがあります。上の表に、すべてのレートとその単位が載っています。

自分の声をクローンできますか?

はい。短いサンプルを録音すれば、どんなテキストにも自分の声を使えます。

Omniboで録音を文字起こしできますか?

はい。どんな録音も、タイムスタンプ付きのきれいなテキストにできます。

次のアイデアは
ここから始まる。

無料アカウントを作成できます。カード登録は不要です。もっと必要になったらアップグレードしてください。

無料アカウントを作成 →