配音 · 语音 · 音乐 · 转写

你的视频,换一种语言。
配音后的音频,大约一分钟就回来。

在 Dub 页面上传文件并选择语言,Omnibo 会把配音以音频文件的形式返回。它不返回视频,也不对口型。2026年11月5日的 4 次测试中,16 到 20 秒的文件各在大约一分钟内返回。

黎明时分的盐滩由 Charon 朗读 · Gemini 3.8 Flash-Lite TTS

配音、声音、
音乐与转写。

把文件配成另一种语言

在 Dub 页面上传,选择一种语言。你会拿回配好音的音频文件,而不是视频,也不对口型。Dubbing v1 的费率为 600 cr / 分钟,需要Starter或更高套餐;Dubbing v2 的费率为 2,640 cr / 分钟,需要Pro或更高套餐。

多种声音的语音

旁白、对话和广告,由你可以先试听的声音朗读。克隆一个你有权使用的声音。

音乐、音效、转写

为场景配上音乐,加入它需要的音效,或把录音变成干净、带时间戳的文字。

在对话里要求配音不会用到这个页面。每项任务最长 10 分钟。该页面默认打开 Dubbing v2;想要更低费率,请选 Dubbing v1。

可在 8 家提供商的 32 个音频模型中选择,每个都有公布的费率。

查看所有模型

语音与音频,
顺着你的工作方式。

把文字转成语音,为场景配上音乐或音效,转写一段录音,或克隆一个你有权使用的声音。

01 / 04

文字转语音

旁白、对白和广告,配上合适的声音。使用前可试听每个声音。

02 / 04

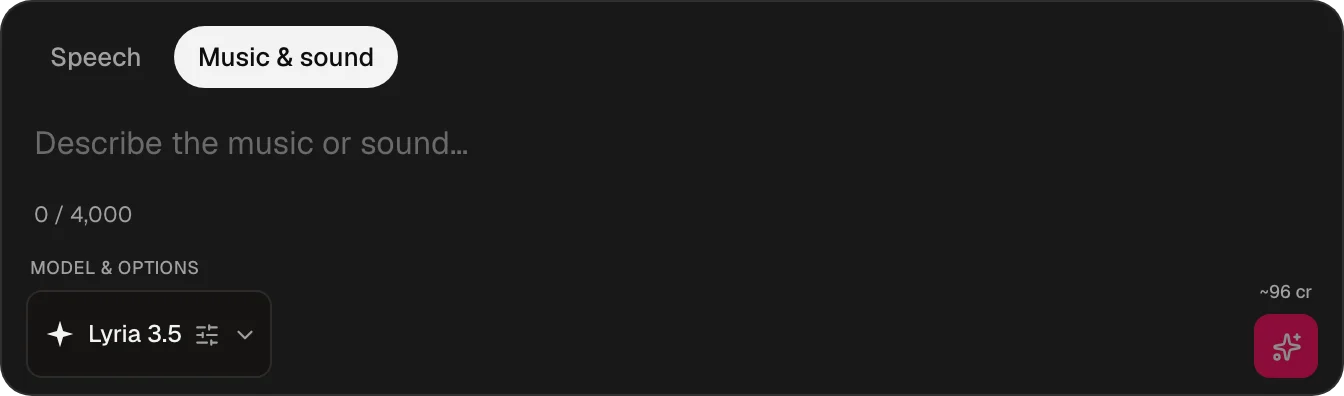
音乐与声音

为一个场景配乐,或加上它需要的音效,都在同一个生成面板里。

03 / 04

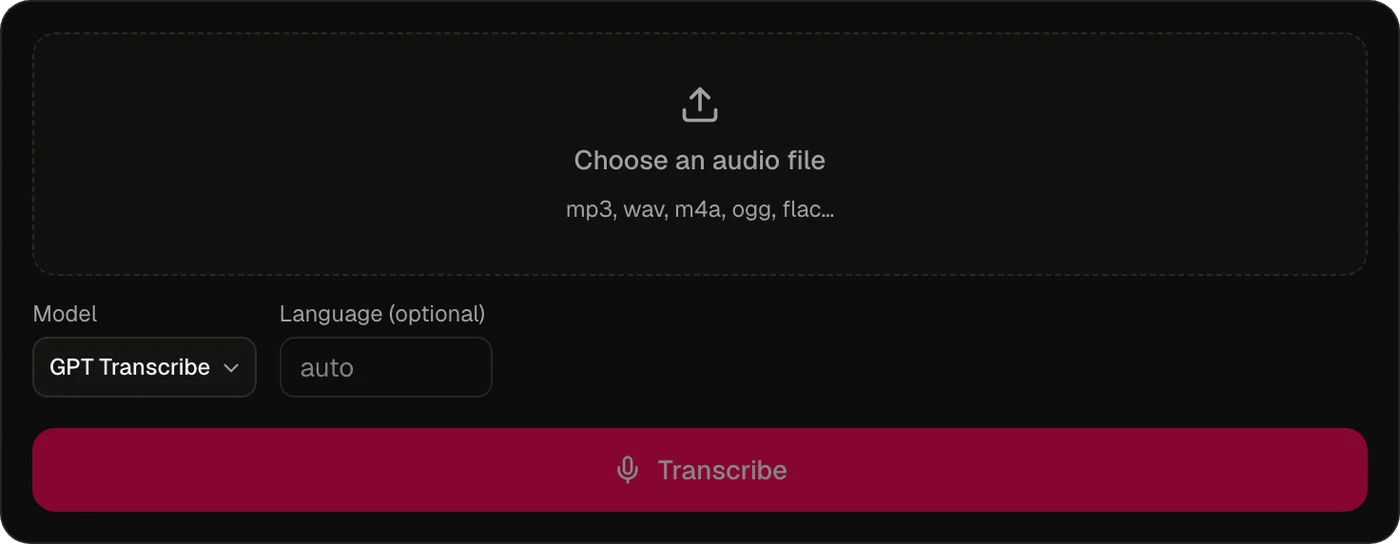
转写任何录音

拖入音频文件,选好模型,也可以选语言,就能得到干净、带时间戳的文字。

04 / 04

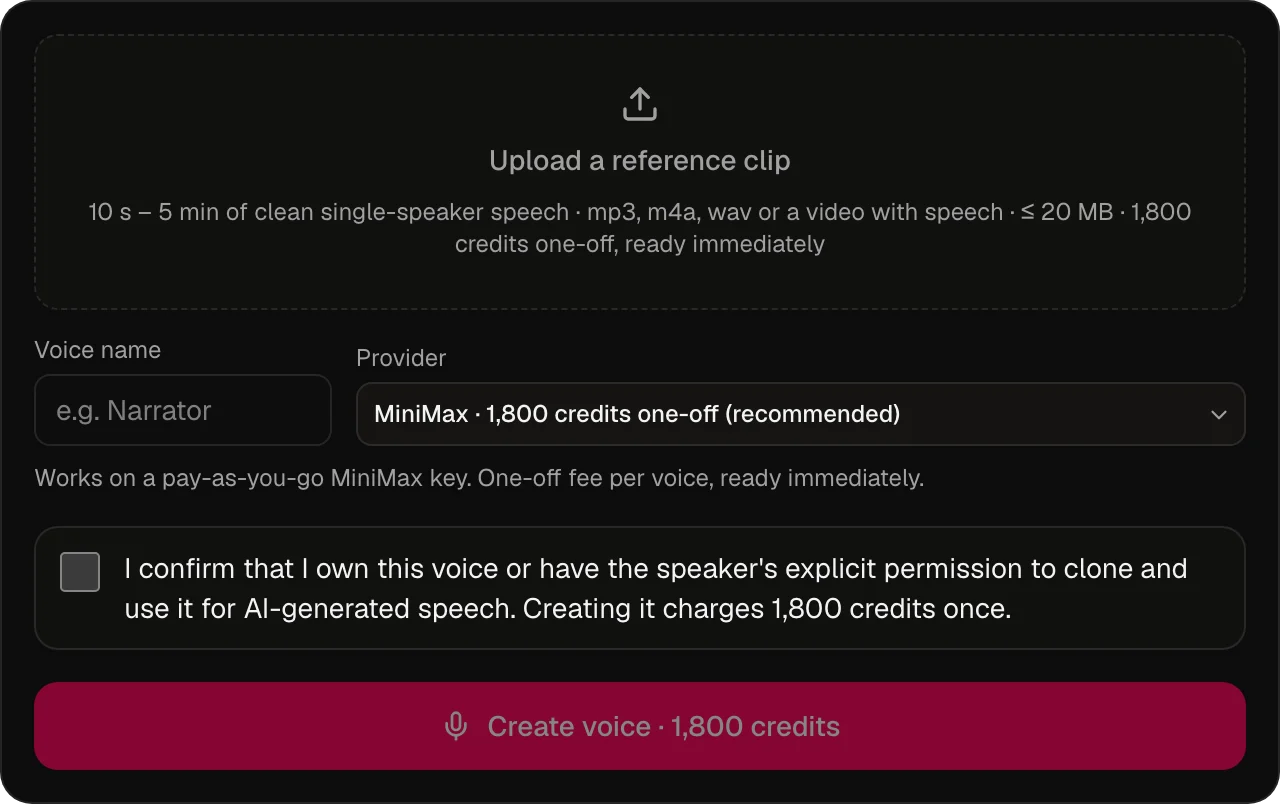
克隆声音

上传一段你有权使用的简短参考音频,给声音起个名字,之后就能用它说话。
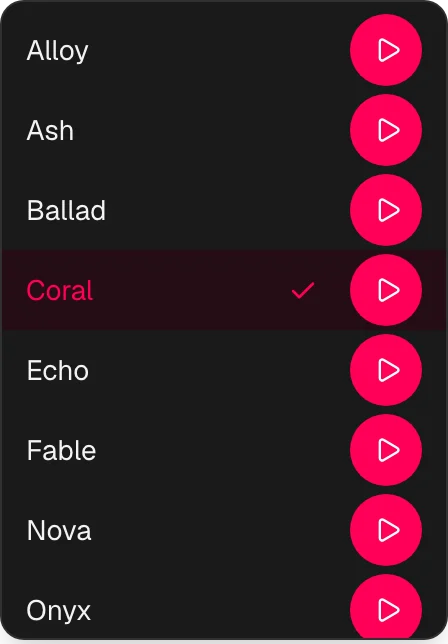
语音列表,每个声音都有播放按钮可试听
处于“音乐与声音”模式的 Omnibo 音频生成面板
Omnibo 转写:拖入录音,选择模型和语言
Omnibo 的声音克隆:上传参考音频、给声音命名、选择提供商

亲自
听一听。

来自社区动态的真实语音,每段都标明朗读它的模型和声音。

四楼的雨由 Enceladus 朗读 · Gemini 3.8 Flash-Lite TTS
睡过头的灯塔由 Leda 朗读 · Gemini 3.8 Flash-Lite TTS
十分钟,无处可去由 sage 朗读 · GPT-4o mini TTS
美好事物的分量由 ballad 朗读 · GPT-4o mini TTS
四号展厅,第九站由 carina 朗读 · Grok Voice
只剩一个信号由 rex 朗读 · Grok Voice

32 个音频模型。
各有各的费率。

每个模型、它的提供商、公布的费率、所需套餐以及上线日期。

全部模型 →
ElevenLabs9 个音频模型
fal.ai7 个音频模型
Google5 个音频模型
OpenAI4 个音频模型
ByteDance2 个音频模型
MiniMax2 个音频模型
xAI2 个音频模型
Kling AI1 个音频模型
模型提供商费率套餐添加时间
ElevenLabs Sound Effects v3ElevenLabs2.4 cr / 秒Starter11月5日 2026
Dubbing v1ElevenLabs600 cr / 分钟Starter11月2日 2026
Dubbing v2ElevenLabs2,640 cr / 分钟Pro11月2日 2026
MiniMax Music 3fal.ai2.4 cr / 秒Pro10月30日 2026
Stable Audio 3 Mediumfal.ai45.1 cr / 个片段Pro10月30日 2026
Stable Audio 3 Small Musicfal.ai26 cr / 个片段Starter10月30日 2026
Stable Audio 3 Small SFXfal.ai24.7 cr / 个片段Starter10月30日 2026
Gemini 3.8 Flash-Lite TTSGoogle25,800 cr / 百万字符Starter10月10日 2026
Gemini 3.8 Flash TTSGoogle38,520 cr / 百万字符Pro10月10日 2026
Eleven v4ElevenLabs96,000 cr / 百万字符Pro10月6日 2026
CassetteAI Sound Effectsfal.ai12 cr / 个片段Starter9月14日 2026
Eleven Flash v2.5ElevenLabs48,000 cr / 百万字符Starter9月14日 2026
Eleven Multilingual v2ElevenLabs96,000 cr / 百万字符Pro9月14日 2026
Eleven Music v2.5ElevenLabs3 cr / 秒Pro9月14日 2026
Eleven v3ElevenLabs96,000 cr / 百万字符Pro9月14日 2026
MiniMax Music 2.6fal.ai180 cr / 个片段Pro9月14日 2026
Scribe v2ElevenLabs4.4 cr / 分钟Starter9月14日 2026
Stable Audio 2.5fal.ai240 cr / 个片段Pro9月14日 2026
Kling Text to AudioKling AI42 cr / 个片段Starter9月13日 2026
Lyria 3 ClipGoogle48 cr / 个片段Starter9月13日 2026
Lyria 3.5Google96 cr / 个片段Pro9月13日 2026
Seed Audio 1.0ByteDance3 cr / 秒Starter9月13日 2026
Gemini 3.5 TranscribeGoogle6 cr / 分钟Starter9月8日 2026
MiniMax Speech 2.8 HDMiniMax120,000 cr / 百万字符Pro8月30日 2026
MiniMax Speech 2.8 TurboMiniMax72,000 cr / 百万字符Pro8月30日 2026
GPT TranscribeOpenAI5.4 cr / 分钟Starter8月8日 2026
GPT-4o mini TTSOpenAI22,800 cr / 百万字符Starter7月5日 2026
Grok TranscribexAI2 cr / 分钟Starter7月5日 2026
Grok VoicexAI18,000 cr / 百万字符Starter7月5日 2026
Seed TTS 1.0ByteDance36,000 cr / 百万字符Starter7月5日 2026
TTS-1OpenAI18,000 cr / 百万字符Starter7月5日 2026
TTS-1 HDOpenAI36,000 cr / 百万字符Pro7月5日 2026

常见问题,
一一解答。

Omnibo 有哪些音频模型?

来自 8 家提供商的 32 个音频模型:ElevenLabs, fal.ai, Google, OpenAI, ByteDance, MiniMax, xAI, Kling AI。最新的是 ElevenLabs Sound Effects v3,添加于 2026年11月5日。

一次音频生成要花多少钱?

每个模型都有自己公布的费率。上方表格列出了每项费率及其单位。

能克隆我自己的声音吗?

可以。录一小段样本,就能用你的声音朗读任何文本。

Omnibo 能转写录音吗?

可以。把任何录音变成干净、带时间戳的文字。

你的下一个创意
从这里开始。

免费创建账户,无需绑定银行卡。需要更多时再升级。

创建免费账户 →